関連するソリューション

ITインフラ

セキュリティサービス
セキュリティ製品
サイバー・セキュリティ・ソリューション部
テクニカルスペシャリスト
ボル カーステン
これまで、私はコンテナに関するいくつかの案件に携わってきました。そのため、今回のテーマには強い関心があります。このテーマを考えるきっかけの一つになったのは、ある記事です。その記事については後ほど紹介します。
セキュリティ業界では長い間、コードを隔離する手段としてコンテナが利用されてきました。これは、悪意のあるコードを実行する場合でも、コンテナ内に置けば、理論上はシステムの他の領域に影響を及ぼせないという考え方です。
しかし最近、カーネルの脆弱性が増加しています。そのため、コンテナは今も有効なセキュリティ境界なのか、コードを隔離するためのより良い方法があるのか、という疑問が出てきました。まずは、コンテナがどのように動作しているのかを見ていきましょう。
コンテナの仕組み
コンピューター上でコンテナを実行するとき、利用者はDocker仕様に沿ったイメージを指定し、そのイメージ内のプログラムを起動します。実行後は、仮想マシンのように見える環境でrootシェルを利用できます。しかし、そのrootは実際には本物のrootとは限りません。詳細は後ほど説明します。
技術的な詳細をかなり省略して説明すると、Dockerコンテナを含むコンテナ技術の基盤の一つがcloneシステムコールです。cloneはforkに似た仕組みで、新しいプロセスを作成します。
cloneシステムコールについての参考URL:
https://man7.org/linux/man-pages/man2/clone.2.html
forkはプロセスのアドレス空間を複製し、コピーオンライト方式で子プロセスを作成します。一方、cloneでは、呼び出し元のプロセスと子プロセスの間で、実行コンテキストのどの部分を共有するかをより細かく制御できます。forkとcloneの大きな違いの一つは、新しい「名前空間(namespace)」を作成できる点です。
Dockerコンテナの中に入ると、利用しているコンピューターとよく似た完全なルートファイルシステムがあるように見えます。実際には、cloneによって新しいマウント名前空間(mount namespace)が作られ、イメージをマウントした場所がプログラムのルートディレクトリ(/)として扱われます。考え方としてはchrootに近いものです。
マウント名前空間だけでなく、ユーザー名前空間も作成できます。例えば、コンテナ内でidコマンドを実行するとrootと表示されることがあります。しかし、ユーザー名前空間を使用している場合、実際にはそのユーザーはホスト側でroot以外のUIDに割り当てられており、本当のroot権限は持っていません。
john@hostos:~$ docker run -it ubuntu /bin/sh
# id
uid=0(root) gid=0(root) groups=0(root)
コンテナ内のidコマンドの実行例
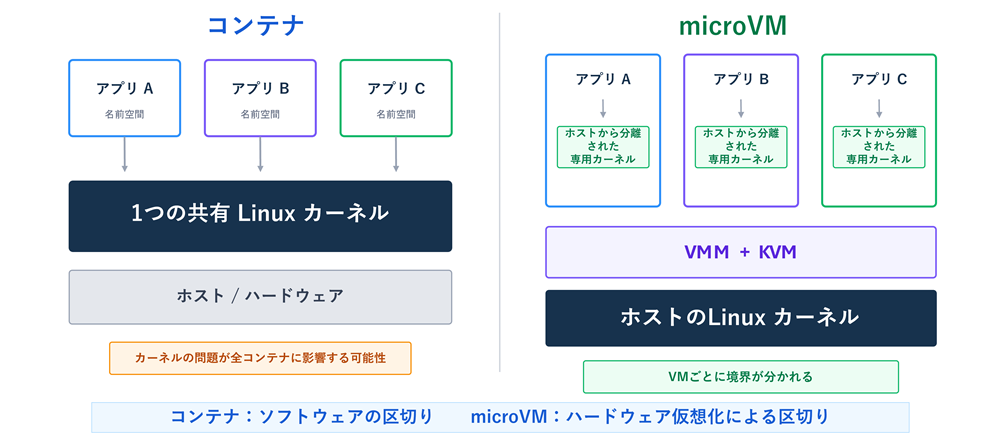
/bin/shなどのプログラムは、複数のフラグを指定したcloneによって実行されます。これにより、ユーザー、プロセスID、ファイルシステム、ネットワークスタックなどに新しい名前空間が与えられます(ユーザー名前空間は設定によります)。その結果、コンテナ内からは、新しいOSを搭載した別のコンピューターを使っているように見えます。しかし実際には、各コンテナは他のコンテナやホストOSと同じカーネルを共有しています。
コンテナが共有するカーネル
このコラムを書くきっかけの一つは、depthfirstに掲載されたZhenpeng (Leo) Lin氏の記事です。そこでは「コンテナはもはやセキュリティ境界ではない」という趣旨が述べられていました。ここでは、コンテナ内部で何が起きているのかを、詳しく知らない方にも分かるように説明します。
参考URL:
https://depthfirst.com/research/containers-are-no-longer-safe
コンテナの名前空間の中にいても、使用しているカーネルはホストや他のコンテナと同じです。UbuntuイメージをDockerで起動しても、新しいLinuxカーネルが作られるわけではありません。各コンテナは、同じカーネルのシステムコールを利用します。
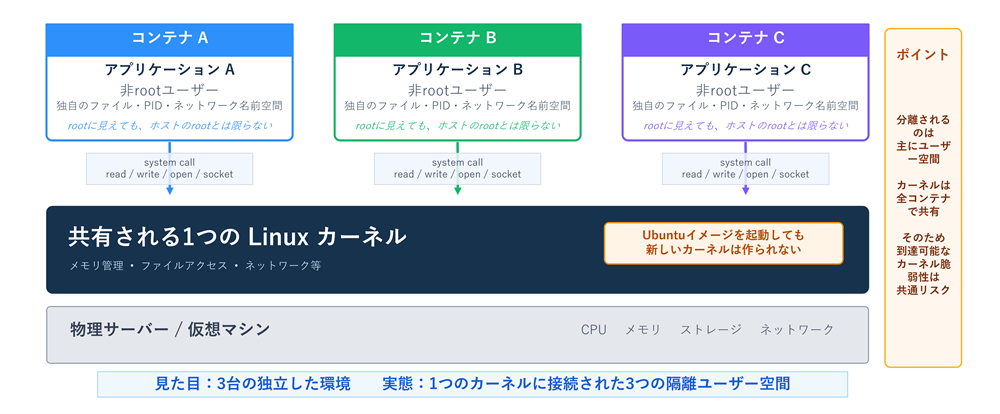
多くの用途では、これは大きな問題になりません。理想的には、コンテナA、コンテナB、コンテナCなどのシステムコール境界が適切に保護されており、さらにインターネットから取得した任意のユーザーコードを実行していなければ、リスクは比較的限定されます。Kubernetes(K8s)も、この前提に基づいて多数のコンテナをオーケストレーションし、アプリケーションの構成に合わせて動作させます。
現在、多くのアプリケーションはクラウドに依存しています。クラウドでは、同じハードウェア上で複数のテナントを動かすマルチテナント構成が一般的です。各テナントはコンテナによって分離されているように見えます。しかし、ここに問題があります。
増加するカーネル脆弱性とローカル権限昇格(LPE)
根本的な疑問は、コンテナが今も有効なセキュリティ境界なのか、ということです。近年、カーネルの脆弱性は急速に増えています。AIがサイバーセキュリティ研究で広く使われるようになり、カーネルのソースコードを解析して脆弱性を見つけることが、以前より容易になったことも一因だと考えられます。
それらの脆弱性の中には、ローカル権限昇格(LPE)につながるものがあります。LPEとは、実行中のプロセスの権限をより高い権限へ昇格させる攻撃です。
一般ユーザーもシステムコールのインターフェースを利用できます。これは特権ユーザーだけのものではありません。ファイルを開く、読み込む、書き込むといった処理は、すべてカーネルが利用者に代わって実行します。利用者がCPUやファイルへ直接アクセスするのではなく、カーネルが処理を仲介し、その操作が許可されているかを確認します。
「そのメモリを参照できるか」「そのネットワークポートへアクセスできるか」といった判断もカーネルが行います。しかし、カーネルやシステムコールのインターフェース自体もコードであり、脆弱性が含まれる可能性があります。AIの活用が進むにつれ、悪用につながり得る既知の脆弱性も増えています。
新たなLPE「Copy Fail」と「Dirty Frag」
今年だけでも、新しい種類のローカル権限昇格の脆弱性が複数確認されています。その例が「Copy Fail」と「Dirty Frag」です。これらは多数ある脆弱性のうちの二つにすぎません。
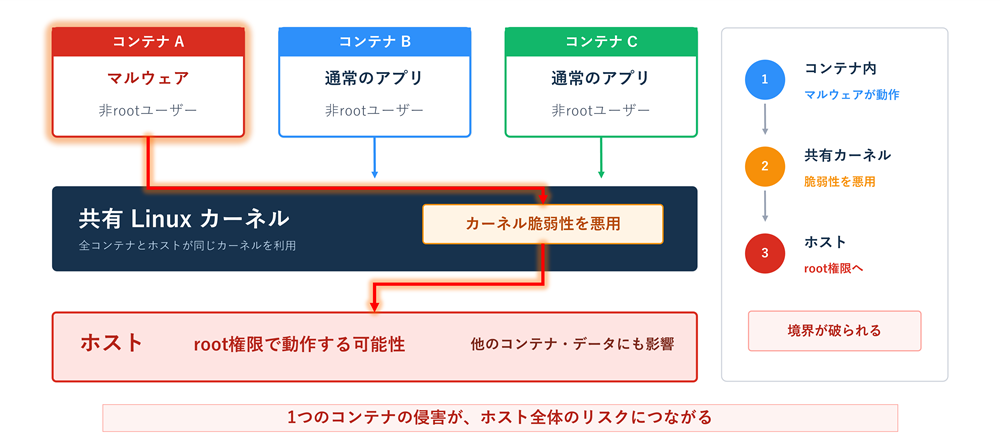
「Copy Fail」は、ソケットに対して暗号処理を行う際のspliceの動作に関係する脆弱性です。この脆弱性を悪用すると、読み取り可能なファイルのページキャッシュに対して、攻撃者が制御する任意の4バイトを書き込める状態が生じます。その結果、攻撃者はsetuidが設定された/usr/bin/suのメモリ上の内容を書き換え、任意のELFファイルをroot権限で実行できる可能性があります。「Dirty Frag」も同様の種類の問題です。こちらは、/etc/passwdの内容を書き換え、suを使用してroot権限を取得できるというものです。
コンテナ内で動作するマルウェアが、自身がコンテナ内にいることを認識し、外部へ脱出しようとした場合を考えてみましょう。そのマルウェアがカーネルの脆弱性を悪用して権限を昇格できれば、コンテナの境界を越えてホスト上で動作する可能性があります。これは、コンテナのセキュリティ境界そのものが破られることを意味します。
Dirty COWからAI時代へ
ローカル権限昇格そのものは新しい問題ではありません。代表的な例として、2016年に公開されたDirty COWがあります。これはLinuxカーネルのコピーオンライト処理に存在した競合状態に起因するローカル権限昇格の脆弱性でした。
当時、この規模の脆弱性が数か月ごとに見つかる状況ではありませんでした。Dirty COWのような重大な脆弱性は1~2年に一度ほど大きなニュースになり、修正パッチを適用して対応する、という印象でした。国家レベルの攻撃者が未公開のゼロデイ脆弱性を保持している可能性は当然あります。とはいえ、Linuxカーネルは広く公開されているため、重大な脆弱性が大量に放置されているとは一般に考えられていませんでした。
しかしAIは、この前提を変えつつあります。現在は、数か月単位で新しい種類の脆弱性が登場しています。Copy FailやDirty Fragは、ソケットに関連するページキャッシュの上書き問題です。他にも、ソケットバッファに関連するFragnesiaやDirtyDecryptなどがあります。
私自身、これらすべてを詳細に調査したわけではありません。それでも、新しい種類の脆弱性が短い間隔で見つかっている点は無視できません。ユーザーがコンテナ内で任意のコードを実行できるオンラインシステムにおいて、コンテナをセキュリティ境界として使用している場合、どのように対応すべきでしょうか。
カーネルを更新するだけで十分か
一つの対応策は、カーネルを常に最新の状態に保つことです。多くの場合、これは有効です。しかし、LPEにつながる脆弱性が頻繁に見つかる状況では、攻撃者に悪用されるより先に更新できるかという競争になります。また、攻撃が行われる時点で、その脆弱性に対する修正パッチが公開されているとは限りません。
私の考えでは、これだけで問題を解決するのは困難です。脆弱性を含み得るカーネルの機能が利用者に公開されていることに変わりはなく、個々のシステムだけでなく、共有しているカーネル全体が侵害される可能性があります。これは、プラットフォームのセキュリティモデル全体に影響します。
解決策の一つとしてのmicroVM
そこで、解決策の一つとして注目されているのがmicroVMです。コンテナの境界に対する懸念が高まる中、microVMの利用は広がりつつあります。コンテナも小さな仮想マシンではないかと思われるかもしれませんが、コンテナは仮想マシンではありません。
Dockerコンテナは、カーネルが提供する名前空間によって隔離されています。そのため、共有カーネルに脆弱性が見つかると、その隔離が破られる可能性があります。
一方、microVMはVMM(Virtual Machine Monitor:仮想マシンモニター)を利用し、プラットフォームのハイパーバイザーによってハードウェアレベルの隔離を実現します。CPU上で各VMに異なるアドレス空間が与えられるため、VM AまたはVM Bがマルウェアに侵害されても、攻撃者がハイパーバイザー自体の脆弱性を見つけない限り、ホストへ直接アクセスすることは困難です。
VMMやKVM(Kernel-based Virtual Machine:カーネルベースの仮想マシン)という用語を知らなくても、次のように考えると理解しやすくなります。CPUには、あるメモリ領域を別の領域から隔離するためのハードウェア機能があります。KVMは、Linuxからその機能を利用できるようにする仕組みです。VMMは、KVMと連携して仮想マシンを作成・管理するソフトウェアです。
microVMを使用してコードをKVM上の仮想マシン内で動作させることで、コンテナAとコンテナBをハードウェアレベルで隔離できます。一方の仮想マシンから他方へ影響を及ぼすには、ハイパーバイザーの脆弱性を悪用する必要があります。
参考URL:
https://www.docker.com/ja-jp/blog/why-microvms-the-architecture-behind-docker-sandboxes/
KVMにも脆弱性はある
もちろん、すべてのソフトウェアには脆弱性が含まれる可能性があります。KVMにも脆弱性は存在し、悪用され得ます。ただし、攻撃対象となる範囲は共有カーネルの場合とは異なります。
Googleは、KVMの脆弱性を対象としたCTF形式の報奨プログラム「kvmCTF」を運営しています。参加者にはKVM上の仮想マシンが提供され、そこから脱出できれば25万米ドルの報奨金が支払われます。実際に、この課題に成功した研究者もいます。
参考URL:
https://github.com/google/security-research/blob/master/kvmctf/rules.md
Hyunwoo Kim氏は、KVMで四つの異なる脆弱性を発見し、そのうち一つでkvmCTFの報奨金を獲得したと報じられています。
一方、Linuxカーネルでは多数の脆弱性が継続的に見つかっています。両者を単純に比較することはできませんが、攻撃対象領域の規模には大きな違いがあります。
最後に
コンテナは、導入や運用がしやすく、多くの場面で非常に有効です。しかし、特に信頼できない任意のコードを実行させる環境では、コンテナだけを強固なセキュリティ境界として扱うことには注意が必要です。
カーネルの更新を継続することは重要ですが、用途によってはmicroVMのようなハードウェアレベルの隔離も検討すべきです。コンテナかmicroVMかを一律に決めるのではなく、実行するコードの信頼度、想定される攻撃、必要な性能、運用負荷を踏まえて、適切な隔離方式を選択することが大切です。
当サイトの内容、テキスト、画像等の転載・転記・使用する場合は問い合わせよりご連絡下さい。
エンジニアによるコラムやIDグループからのお知らせなどを
メルマガでお届けしています。